O arquivo robots.txt é uma ferramenta fundamental para gerenciar o acesso de crawlers a um site. Com a crescente utilização de ferramentas de busca baseadas em inteligência artificial, é crucial entender quais regras cada tipo de bot segue. Isso se torna ainda mais importante, pois bloquear o bot errado pode excluir seu conteúdo de resultados de mecanismos de busca, enquanto deixar URLs desnecessárias acessíveis pode desperdiçar o orçamento de rastreamento em sites grandes.
O Que É Robots.txt?
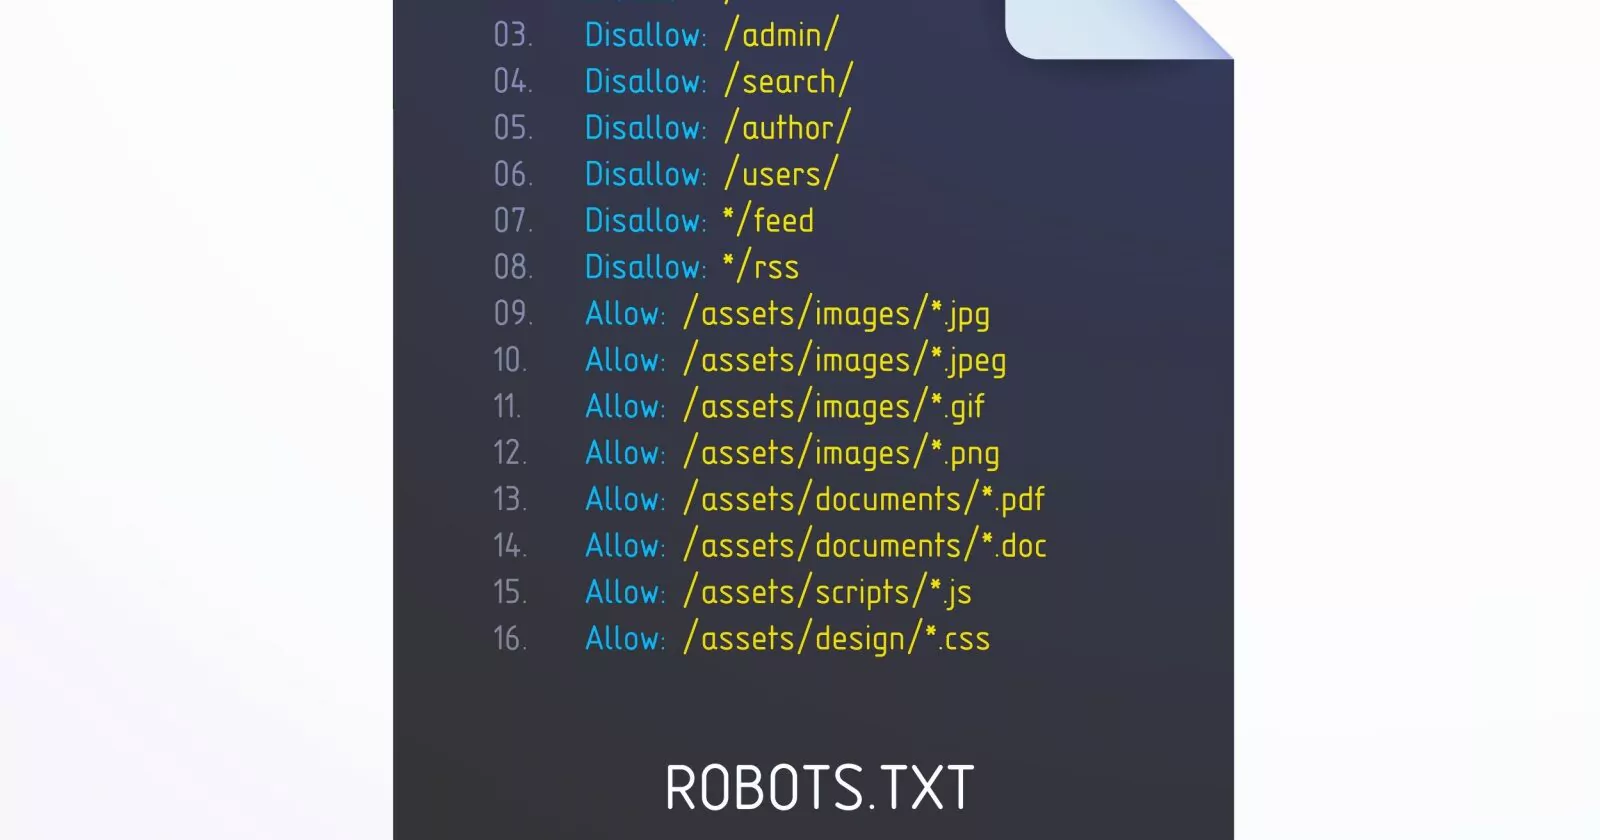
O robots.txt é um arquivo simples que reside no diretório raiz do seu site e indica aos crawlers quais partes do site devem ser rastreadas. Este arquivo contém diretrizes que podem influenciar a visibilidade e o desempenho de páginas em mecanismos de busca.
- User-agent: Define quais crawlers as regras se aplicam.
- Disallow: Indica quais URLs não devem ser rastreados pelos crawlers.
- Allow: Permite que URLs específicas sejam rastreadas, mesmo que um diretório pai esteja restrito.
- Sitemap: Indica a localização do Sitemap XML do site para facilitar a descoberta.
Importância do Robots.txt para SEO
O uso adequado do robots.txt é crucial para otimizar o orçamento de rastreamento. Bloquear páginas que não necessitam de visibilidade, como termos de serviço ou políticas de privacidade, permite que os crawlers gastem seu tempo em URLs realmente relevantes, como páginas de produtos. Uma advertência importante é que bloquear páginas não garante sua remoção dos resultados de busca se houver links apontando para elas.
Quando Usar Robots.txt
É aconselhável utilizar o robots.txt sempre que houver URLs que não sejam relevantes para os mecanismos de busca. Abaixo estão exemplos de situações em que é apropriado restringir o rastreamento:
- Páginas de resultados de busca interna.
- URLs de navegação facetada, que frequentemente criam conteúdo duplicado.
- Arquivos PDF que você não deseja que sejam indexados.
Bloqueando Páginas Inúteis
Para prevenir que URLs de busca interna sejam rastreadas, você pode usar as seguintes regras:
User-agent: *
Disallow: /*?s=
Disallow: /*?*&s=
Gerenciamento Centralizado do Robots.txt
A gestão do robots.txt se torna complexa quando um site possui múltiplos subdomínios. Para simplificar, é possível hospedar um único arquivo de robots.txt em um subdomínio e redirecioná-lo para o domínio principal, facilitando as atualizações e manutenção.
Robots.txt e Crawlers de IA
É importante distinguir entre crawlers de treinamento e aqueles que fazem buscas. Você pode permitir que bots que buscam informações acessem suas páginas, enquanto restringe aqueles que coletam dados para treinamento. Por exemplo:
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Disallow: /private/
Os parâmetros das regras no robots.txt permitem que você controle com precisão como os crawlers interagem com seu site, impactando diretamente a visibilidade e o desempenho nas buscas. Uma configuração adequada delibera sobre quais conteúdos serão acessíveis e qual valor seu site oferece aos usuários e aos mecanismos de busca.