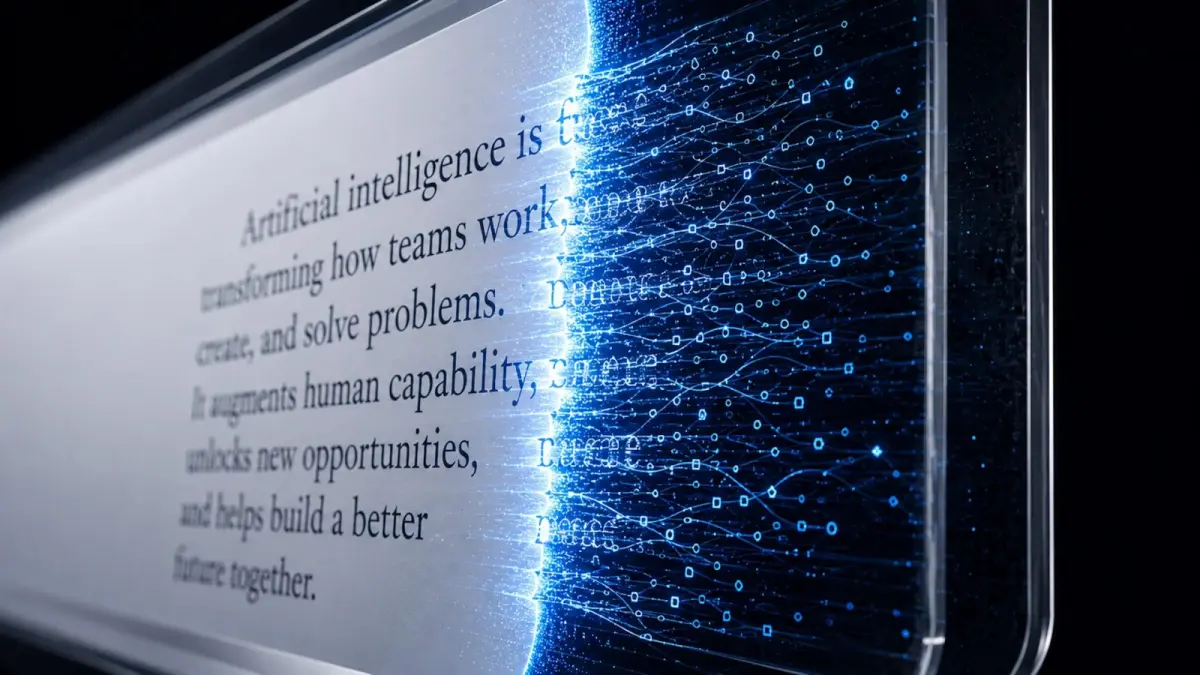
A OpenAI irá implementar uma marca d’água invisível em textos do ChatGPT e do Codex para usuários qualificados na União Europeia nas próximas semanas. Os testes da empresa indicam que substituir certas palavras por sinônimos pode reduzir significativamente a eficácia desta marca – em um experimento, a troca de 25% das palavras em trechos de 400 tokens levou as taxas de detecção de aproximadamente 92% para apenas 17%.
Implementação Específica na União Europeia
A marca d’água do ChatGPT e do Codex será acessível apenas para usuários elegíveis dentro da EU. O recurso de marcação de texto não será uma função padrão em escala global inicialmente. A atualização de 5 de outubro não especifica quais modelos estão inclusos neste recurso optativo ou se usuários do ChatGPT na EU podem desativar a marca.
Motivos para a Escolha do Mercado Europeu
As regras de transparência sob o Artigo 50 da Lei de IA da UE começaram a vigorar em 2 de agosto de 2026. O prazo para que sistemas de IA introduzidos no mercado antes dessa data se adequem às exigências de marcação será até 2 de dezembro. Em julho, cerca de 190 organizações já haviam assinado um código de prática de transparência. A OpenAI manifestou apoio a este código em junho.
A decisão de implementar a marca d’água apenas na EU permite que a OpenAI aprenda com o uso e o feedback no mundo real. Essa estratégia se tornou mais relevante após a empresa decidir não marcar textos do ChatGPT em agosto de 2024, quando quase 30% dos usuários afirmaram que usariam o serviço menos caso a marca fosse implementada.
Resultados dos Testes da OpenAI
A metodologia da OpenAI, chamada textGrain, adiciona um sinal estatístico nas escolhas de palavras do modelo que um detector pode identificar. Em testes visando uma taxa de falso positivo de 1%, o detector encontrou a marca d’água em aproximadamente 80% de trechos de 200 tokens e cerca de 95% de 400 tokens, especialmente em conteúdos como psicologia. Contudo, taxas muito mais baixas foram observadas em conteúdos como matemática, onde a escolha de palavras é menos flexível.
Foi notado que a edição do texto enfraqueceu o sinal nas passagens de 400 tokens. A substituição de 10% das palavras por sinônimos reduziu a detecção de cerca de 92% para 66%, enquanto 25% de substituição diminuiu para 17%. As respostas utilizadas nos testes vieram do conjunto de dados ELI5.
Acesso ao Detector de Marca d’Água
Apenas pesquisadores e organizações especializadas poderão solicitar acesso ao detector de texto da OpenAI, inicialmente de maneira individual. O instrumento indicará se detecta uma marca da OpenAI, porém não revelará a identidade do usuário nem suas solicitações e diálogos. Devido ao risco de marcas não detectadas e potenciais falsos positivos, o acesso ao público não estará disponível neste lançamento. Em contraste, ferramentas de verificação para imagens e áudios permanecem abertas a todos.
Comparação com a Anthropic
A Anthropic, por sua vez, marca textos de modelos suportados do Claude em todo o mundo, mas ainda não possui uma maneira robusta de restringir a marcação por região. Isso demonstra uma diferença em como as duas empresas estão abordando a questão da marcação de textos gerados por IA.
O Impacto Prático da Marca d’Água
Para empresas de comunicação que operam em múltiplas localizações, pode haver situações em que textos gerados pelo ChatGPT apresentem marcas de água em certos locais e não em outros, impactando a integridade contratual e políticas de autoria. A marca d’água está longe de ser uma prova conclusiva da autoria.
Perspectivas Futuras
A OpenAI planeja ampliar o acesso ao detector assim que se sentir capaz de garantir uma interpretação responsável dos resultados. À medida que a marcação se inicia na UE, equipes que trabalham com o ChatGPT na região começarão a criar conteúdos marcados, cujas revisões estarão disponíveis somente para pesquisadores aprovados e organizações especializadas.